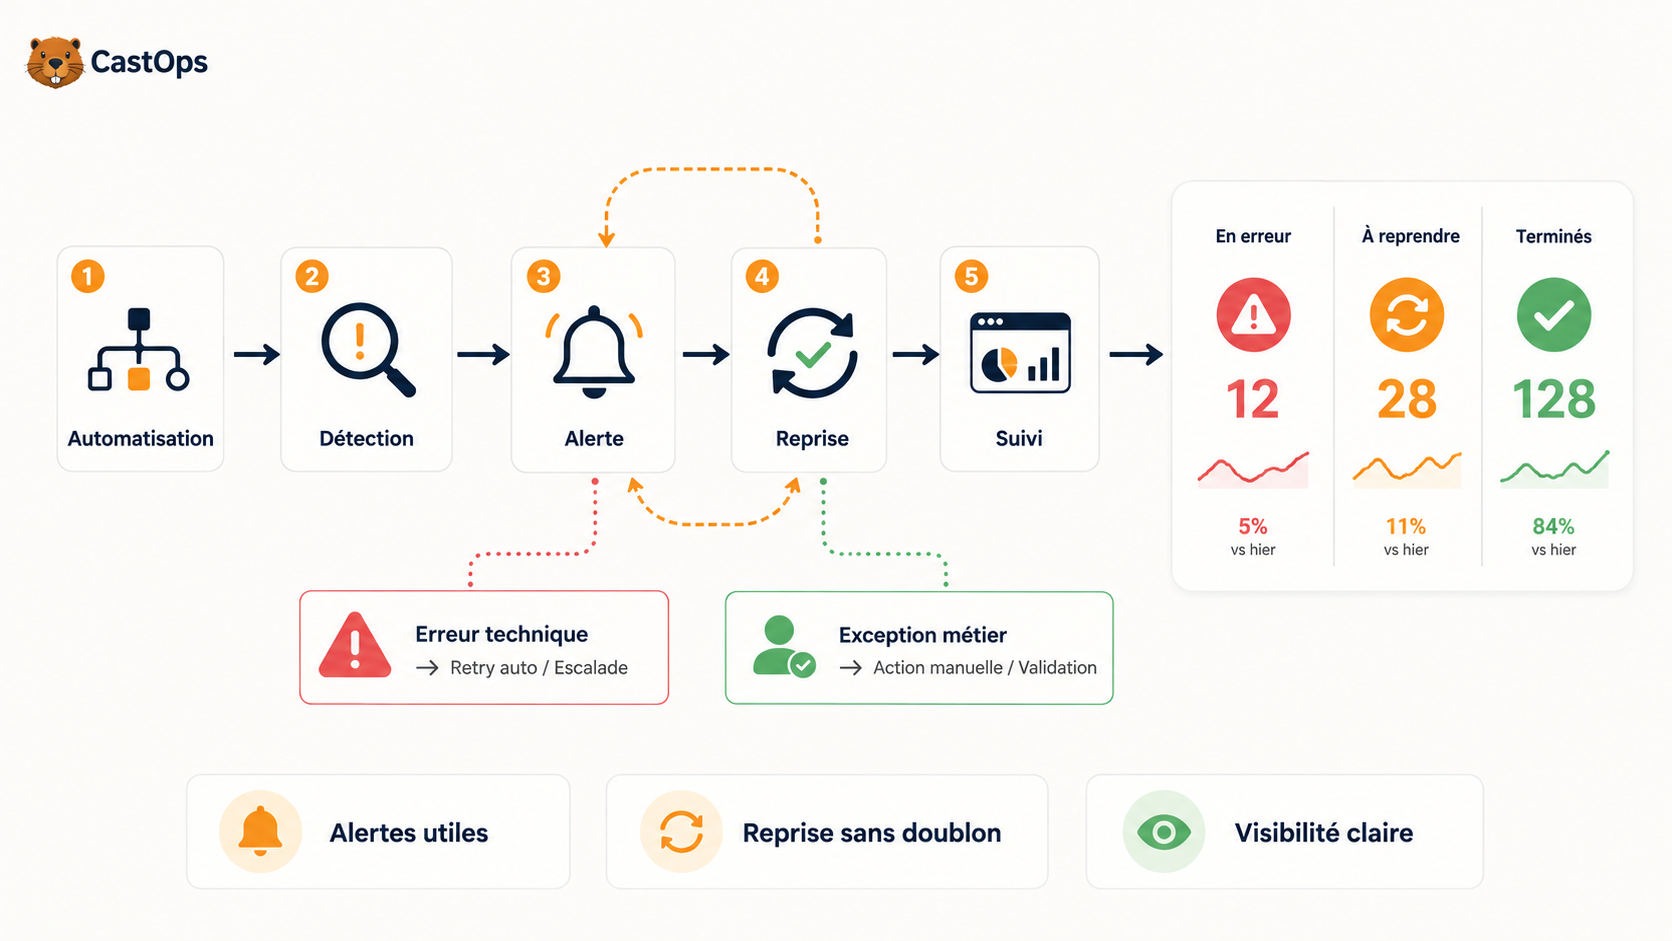
Une automatisation peut fonctionner correctement pendant des semaines puis rencontrer un fichier inattendu, une donnée absente ou un logiciel temporairement indisponible.
Le vrai risque n’est pas qu’une erreur survienne. Aucun système connecté à plusieurs outils ne peut promettre qu’il n’en rencontrera jamais. Le risque est que cette erreur reste invisible et bloque silencieusement des dossiers.
Une automatisation professionnelle doit donc prévoir ce qui se passe lorsqu’une étape échoue. La surveillance, les alertes et la reprise font partie de la solution dès sa conception.
Pourquoi une automatisation peut-elle échouer ?
Les causes sont nombreuses et ne viennent pas toujours du workflow lui-même.
Parmi les situations fréquentes :
- une information obligatoire n’a pas été renseignée
- un fichier possède un format inhabituel
- un utilisateur a modifié une colonne ou un statut
- l’API d’un logiciel ne répond plus temporairement
- un droit d’accès a expiré
- une donnée existe déjà dans l’outil de destination
- le volume traité dépasse une limite
- une règle métier a changé sans être répercutée
- un service externe renvoie une réponse différente
Certaines erreurs peuvent être résolues automatiquement. D’autres demandent une décision humaine.
Distinguer erreur technique et exception métier
Une erreur technique empêche le système d’exécuter une action prévue. Une exception métier correspond à une situation valide, mais qui sort du chemin habituel.
Par exemple, l’indisponibilité d’un CRM est une erreur technique. Une demande dépassant un montant nécessitant une validation particulière est une exception métier.
Cette distinction permet d’adresser le problème à la bonne personne :
- l’équipe chargée du système pour une panne ou une connexion rompue
- un responsable opérationnel pour une décision liée au dossier
- l’utilisateur concerné lorsqu’une donnée doit être complétée
Envoyer toutes les anomalies dans la même boîte finit par rendre les alertes inutilisables.
Enregistrer chaque exécution utilement
Un historique doit permettre de répondre rapidement à quelques questions :
- quel dossier a été traité ?
- quand le traitement a-t-il commencé ?
- quelles étapes ont réussi ?
- à quel endroit le blocage s’est-il produit ?
- quelle donnée ou réponse a provoqué l’erreur ?
- une nouvelle tentative a-t-elle eu lieu ?
- une personne a-t-elle repris le dossier ?
Il ne s’agit pas d’exposer des journaux techniques complexes à toute l’entreprise. Les équipes métier ont besoin d’un statut compréhensible, tandis que les personnes chargées de la maintenance doivent pouvoir accéder au détail nécessaire.
Concevoir des alertes qui appellent une action
Une alerte utile explique ce qui s’est passé et ce que la personne doit faire.
Elle devrait contenir :
- le dossier concerné
- la nature du problème
- l’étape atteinte
- le niveau d’urgence
- le lien vers les informations utiles
- l’action attendue
- l’existence éventuelle d’une nouvelle tentative automatique
Une notification générique comme « workflow en erreur » oblige à enquêter avant même de savoir si le problème est important.
Choisir le bon niveau d’alerte
Toutes les erreurs ne justifient pas un message immédiat.
Un service peut être indisponible pendant quelques secondes puis fonctionner à la tentative suivante. À l’inverse, un dossier urgent bloqué doit être signalé rapidement.
Il est possible de prévoir :
- une nouvelle tentative automatique pour les erreurs temporaires
- une alerte groupée pour les incidents non urgents
- une notification immédiate pour un blocage critique
- un tableau de bord pour les dossiers en attente
- une escalade lorsqu’un problème reste sans traitement
Ce réglage évite que l’équipe reçoive trop de messages et cesse de les lire.
Permettre une reprise sans recommencer tout le processus
Lorsqu’une étape échoue après plusieurs actions réussies, relancer l’ensemble peut créer des doublons. Un second dossier, un nouvel email ou un document supplémentaire peut alors être généré.
La reprise doit tenir compte de ce qui a déjà été effectué. Selon le processus, elle peut :
- reprendre à l’étape en erreur
- vérifier si l’action a déjà abouti avant de la répéter
- demander une correction puis continuer
- annuler proprement certaines opérations
- transmettre le dossier à une personne
Cette capacité est particulièrement importante lorsque le workflow modifie plusieurs logiciels.
Prévoir une file de traitement manuel
Une automatisation fiable ne cherche pas à forcer tous les dossiers dans les règles existantes. Les cas impossibles à traiter doivent rejoindre une file claire.
Pour chaque dossier, l’utilisateur doit voir :
- la raison du blocage
- les informations disponibles
- les actions déjà réalisées
- la décision attendue
- la manière de poursuivre ensuite
Après l’intervention humaine, le processus peut reprendre sans perdre son historique.
Surveiller aussi la qualité du résultat
Un workflow peut terminer sans erreur technique tout en produisant un résultat incorrect. Une mauvaise règle d’affectation ou une donnée mal interprétée ne provoque pas toujours de panne.
Il faut donc suivre des indicateurs métier, par exemple :
- le nombre de dossiers terminés
- les traitements inhabituellement longs
- la proportion de reprises manuelles
- les dossiers sans statut final
- les doublons détectés
- les écarts entre les volumes entrants et sortants
Ces contrôles permettent d’identifier un fonctionnement dégradé avant qu’il ne soit signalé par un client ou un collaborateur.
Anticiper les changements dans les outils
Les logiciels connectés évoluent. Un champ peut être renommé, une autorisation révoquée ou une API modifiée.
Pour limiter les interruptions :
- documentez les connexions importantes
- identifiez le propriétaire de chaque outil
- surveillez les échecs inhabituels
- testez les changements avant leur mise en production
- conservez un moyen de traiter temporairement les dossiers
- prévoyez la maintenance de l’automatisation
Une solution n’est pas terminée le jour où elle est mise en service. Elle doit accompagner l’évolution du processus et de son environnement.
Tester avec des situations réalistes
Un test limité au cas idéal ne suffit pas. Avant la mise en production, utilisez plusieurs scénarios :
- dossier complet
- information manquante
- doublon
- format de fichier incorrect
- réponse lente d’un outil
- refus d’une validation
- exception nécessitant une reprise humaine
L’objectif est de vérifier à la fois le traitement normal et la manière dont le système s’arrête.
CastOps conçoit des automatisations de processus avec contrôles, alertes et reprises afin qu’elles puissent être réellement utilisées au quotidien.
FAQ
Une automatisation peut-elle fonctionner sans maintenance ?
Un processus très stable peut demander peu d’interventions, mais les outils, les données et les règles métier évoluent. Un suivi minimal reste nécessaire pour détecter les changements et corriger les incidents.
Faut-il prévenir quelqu’un à chaque erreur ?
Non. Les erreurs temporaires peuvent parfois être retentées automatiquement. Les alertes doivent être classées selon leur impact et adressées à la personne capable d’agir.
Peut-on relancer un traitement sans créer de doublon ?
Oui si la reprise a été prévue. Le système doit vérifier les actions déjà réalisées et reprendre au bon endroit plutôt que répéter aveuglément tout le parcours.
Comment savoir qu’un workflow fonctionne toujours ?
Il faut surveiller les exécutions techniques et quelques indicateurs métier. L’absence d’erreur affichée ne garantit pas à elle seule que tous les dossiers ont été traités correctement.
Vos automatisations manquent-elles de visibilité ?
Nous pouvons analyser votre processus, ses points de défaillance et les reprises nécessaires pour concevoir un fonctionnement que l’équipe peut réellement superviser.